


一. MYSQL存储引擎
InnoDB
除了 MyISAM 存储引擎,MySQL 中另一个常用的存储引擎是 InnoD
InnoDB 的介绍

InnoDB 存储引擎不同于 MyISAM 存储引擎,能够支持事务安全镖(ACID 兼容),具有提交、回滚和崩溃恢复的能力
InnoDB 支持行级锁定,并且可以在 SELECT 语句中提供一个与 Oracle 风格类似的非锁定读,也支持 FOREIGN KEY 强制
InnoDB的 特点
支持事务,支持四个事务隔离级别
行级锁定,但是全表扫描仍然会是标记锁定
读写阻塞与事务隔离级别相关
具有非常高效的缓存特性,能缓存索引,也能缓存数据
表与主键以簇的方式存储
支持分区、表空间,类似 Oracle 数据库
支持外键约束,MySQL 5.5 以前不支持全文索引,5.5 版本以后支持
适合对硬件资源要求比较高的场合
MyISAM
MyISAM不支持事务,也不支持外键约束,只支持全文索引,数据文件和索引文件是分开保存的
访问速度快,对事务完整性没有要求
MyISAM 适合查询、插入为主的应用场景
存储引擎的选择
根据应用系统的特点选择合适的存储引擎
MyISAM
不需要事务支持(不支持)
并发相对较低(锁定机制问题)
数据修改相对较少(阻塞问题),以读为主
数据一致性要求不是非常高
InnoDB
需要事务支持(具有较好的事务特性)
行级锁定对高并发有很好的适应能力,但需要确保查询是通过索引完成
数据更新较为频繁的场景
数据一致性要求较高
硬件设备内存较大,可以利用InnoDB较好的缓存能力来提高内存利用率,尽可能减少磁盘 IO
二.索引
https://www.cs.usfca.edu/~galles/visualization/Algorithms.html
B+树索引简单分析
MySQL中,索引是在存储引擎层实现的,不同的存储引擎支持的索引类型不同,对索引的组织实现方式也不同。我们平时最常使用的是B+树索引,B+树是为磁盘或其他存取设备设计的一种平衡查找树,所有记录节点按照键值大小顺序存放在同一层的叶节点上,各叶节点通过指针进行链接,先来看一个B+树的结构图
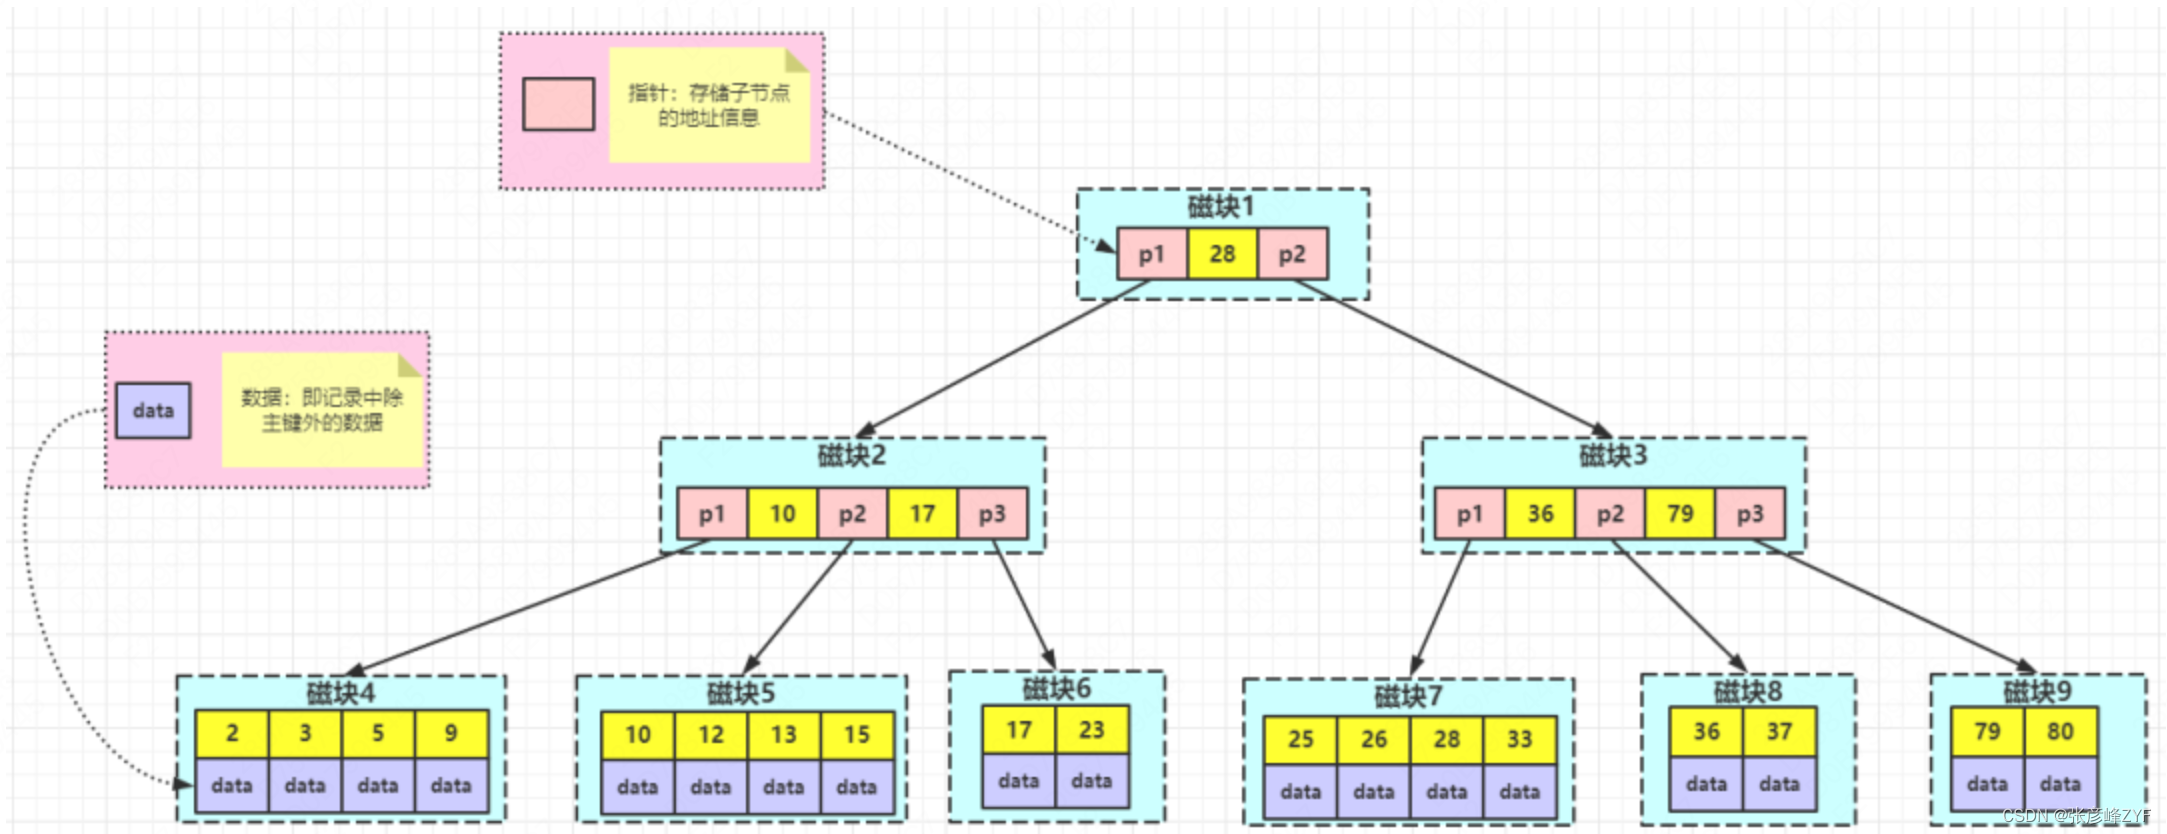
通过图可以看到其基本特征如下:
非叶节点只存关键字以及索引下一层节点的指针
所有叶节点在同一层,包含全部关键字和指向记录的指针,并且按照关键字从小到大顺序链接
可以看到相比一般二叉树,B+树的单个节点能存储更多信息,减少了磁盘 IO 的次数,从而提升了查找速度,而且叶节点形成有序链表,非常适合进行范围查询。
Hash表
在java中的HashMap,TreeMap是Hash表结构,以键值对的方式存储数据,使用Hash表存储表数据Key可以存储索引列,Value可以存储行记录或者行磁盘地址。Hash在等值查询效率高,时间复杂度是O(1),但是,不支持范围快速查找,范围查找时只能通过扫描全表方式
不适合经常需要查找和范围查找的数据库索引使用
索引分类
聚集索引(Clustered Index)
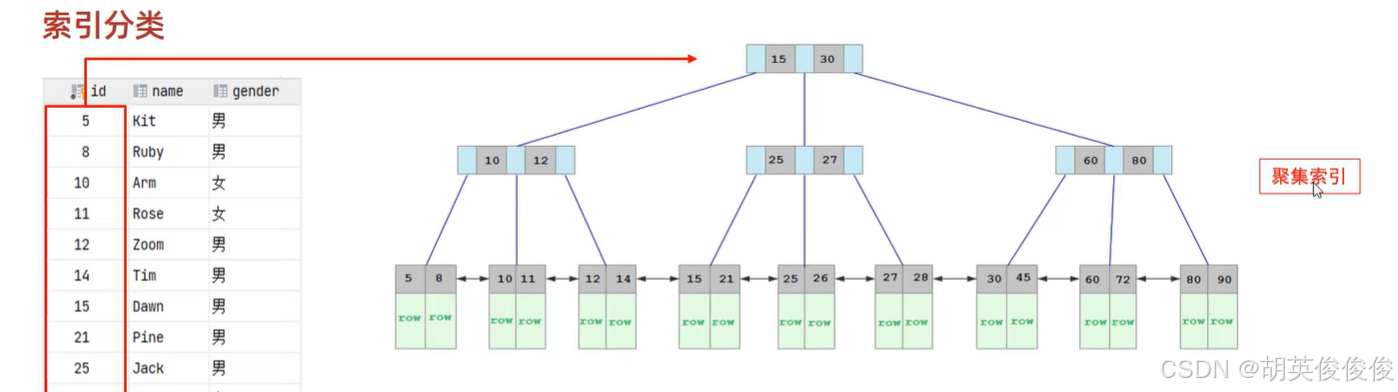
1.1 聚集索引的定义
聚集索引是一种根据表中某列的值对数据进行物理排序的索引。在 MySQL 的 InnoDB 存储引擎中,聚集索引的结构是一个B+树,并且数据表的物理存储顺序与索引的顺序保持一致。也就是说,数据存储按照主键或唯一索引的顺序排列。
InnoDB 表的主键索引就是聚集索引,如果没有定义主键,InnoDB 会选择第一个非空唯一索引作为聚集索引;如果没有找到这样的索引,InnoDB 会自动创建一个隐式的主键列作为聚集索引。
1.2 聚集索引叶子节点存储什么数据?
聚集索引的叶子节点不仅存储索引列的值,还存储该行的所有数据,即整行记录。由于叶子节点中包含了完整的数据行,所以不需要额外进行回表操作,这也是聚集索引区别于其他索引的关键特性。
1.3 聚集索引的特点
唯一性:每张表只能有一个聚集索引,因为数据的物理存储只能有一种顺序。
高效查询:由于数据和索引一起存储,当根据聚集索引进行查询时,系统只需从 B+树中找到对应的叶子节点即可获取完整的行数据,查询性能非常高。
占用空间大:由于叶子节点存储的是完整的数据行,索引树的叶子节点会占用较大的空间。
插入和更新成本高:插入或更新数据时,可能需要移动大量数据行来保持物理排序,从而导致性能开销。
1.4 适用场景
聚集索引非常适合以下场景:
主键查询:当以主键为条件查询时,InnoDB 直接使用聚集索引查找,速度极快。
范围查询:由于聚集索引按照顺序存储数据,执行范围查询(如 BETWEEN 或 ORDER BY)时,数据库可以有效地扫描一段连续的物理数据块。
二级索引(Secondary Index / Non-clustered Index)
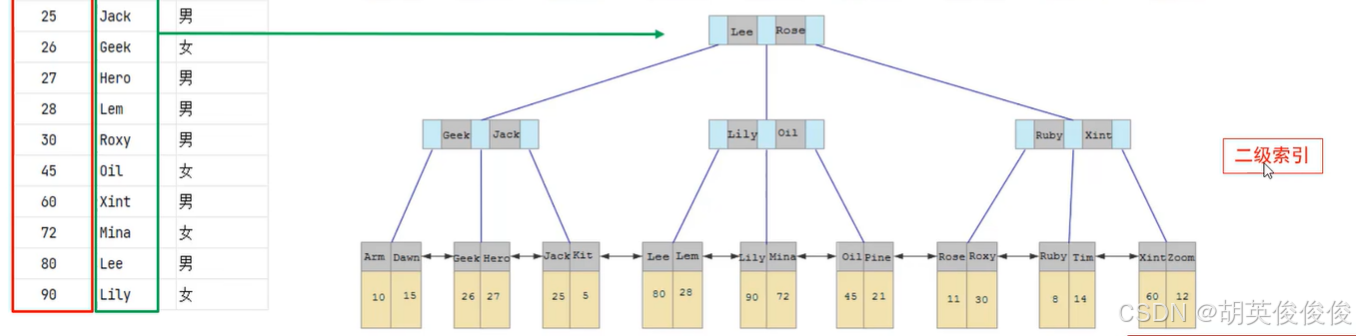
二级索引的定义
二级索引,也称为非聚集索引,是指数据的物理存储顺序与索引顺序无关的一类索引。它是单独创建的一棵 B+ 树,用于加速对非主键列的查询。一个表可以有多个二级索引,这些索引不会改变数据的物理存储顺序,而是额外维护一棵独立的索引树。
二级索引通过为非主键列创建索引来提高查询效率,特别是在数据筛选条件不包含主键的场景下非常有用。
2.2 二级索引叶子节点存储什么数据?
二级索引的叶子节点与聚集索引不同。二级索引的叶子节点不存储完整的行数据,而是存储:
索引列的值:这是查询条件中的字段值。
聚集索引的主键值:二级索引的叶子节点存储主键值,通过主键值可以查找到对应的完整行数据。
当我们使用二级索引查询时,首先根据查询条件在二级索引树中找到匹配的索引列,然后通过存储在叶子节点中的主键值回到聚集索引中找到完整的数据行。这一过程称为“回表”。
2.3 二级索引的特点
多个二级索引:表中可以创建多个二级索引,以加速不同列上的查询。
回表查询:由于叶子节点只存储索引列和主键值,查询完整行数据时需要通过主键值回到聚集索引中查找完整数据。
空间占用小:二级索引的叶子节点只存储索引列和主键值,相比于聚集索引,二级索引的叶子节点占用更少的存储空间。
2.4 适用场景
二级索引适合以下场景:
非主键列查询:当查询条件不包含主键列,而是基于其他列时,二级索引可以显著提升查询性能。
频繁的查询:对于经常需要根据某些非主键列进行过滤或排序的场景,二级索引是非常有效的。
索引语法
普通索引
CREATE INDEX indexName ON mytable(username(length));
唯一索引
CREATE UNIQUE INDEX indexName ON mytable(username(length)) 修改表结构
组合索引
CREATE TABLE mytable( ID INT NOT NULL, username VARCHAR(16) NOT NULL, city VARCHAR(50) NOT NULL, age INT NOT NULL );
查看索引
show index from emp;
删除索引
DROP INDEX index_name ON table_name;
SQL性能分析
SHOW GLOBAL STATU lIKE Com'_______';
慢查询日志
slow_query_log = 1
#打开慢查询
slow_query_log_file = /var/log/mysql/mysql-slow.log
#设置慢查询数据存储文件位置
long_query_time = 2
#设置查询时间超过2s则记录
log_queries_not_using_indexes = 1
#记录不使用索引的查询
tail -f mysql-slow.log 监视慢查询语句
profile 查看指令的执行耗时
查看每一条SQL语句的耗时基本情况

show profiles;

查看指定query_id 的SQL语句各个阶段的耗时情况
show profile for query query_id;

查看指定query_id 的SQL语句CPU的使用情况
show profile CPU for query query_id;
explain执行计划
语法:
在任意SELECT语句前加explain/desc
id
每个select对应一个id值,其值是按 select 出现的顺序增长的。
注:id值越大执行优先级越高,id相同则从上往下执行,id为NULL最后执行
select_type
每个select对应一个select_type,表示select的复杂度,有:
SIMPLE:简单查询。查询不包含子查询和union,如上图
PRIMARY:对于包含UNION、UNION ALL或者子查询的大查询来说,它是由几个小查询组成的,其中最左边的那个查询的select_type值就是PRIMARY

SUBQUERY:包含在 select 中的子查询(不在 from 子句中)

DERIVED:对于包含‘派生表’的查询

UNION:在 union 中的第二个和随后的 select
type
这一列表示关联类型或访问类型
效率从最优到最差分别为:system > const > eq_ref > ref > range > index > ALL
SQL性能优化的目标:至少要达到range级别,要求是ref级别,最好是consts级别。
system:当表中只有一条记录并且该表使用的存储引擎的统计数据都是精确地,表最多有一个匹配行,读取1次,速度比较快。
const:system是 const的特例,表里只有一条元组匹配时为system
eq_ref:primary key 或 unique key 索引的所有部分被连接使用 ,最多只会返回一条符合条件的记录。
ref:相比 eq_ref,不使用唯一索引,而是使用普通索引或者唯一性索引的部分前缀,索引要和某个值相比较,可能会 找到多个符合条件的行。
range:用索引获取某些范围区间的记录。
possible_keys
标识某个表查询时可能使用哪些索引来查找。
key
实际使用哪个索引。
当possible_keys有值,而key没有值时,可能是因为表数据很少,mysql认为没有必要走索引,直接全表查询了。
当possible_keys为null时,可根据实际情况在where条件中添加索引来提升查询效率。
索引使用
1、最左前缀法则
如果索引了多列(联合索引),要遵守最左前缀法则。最左前缀法则指得是查询从索引的最左列开始,并且不跳过索引中的列(存在即可,与查询条件的位置先后无关)。如果跳跃某列,则后面的字段索引失效。
举个例子,当你创建了联合索引(a、b、c),当你按照b、c查询时,就不会使用你创建的联合查询查询,而是采用全文索引查询。当按照a、c查询时,a字段会使用联合索引,而由于没有b字段,c字段失效。
2、范围查询
联合索引中、出现范围查询(>、<),范围查询右侧的列索引会失效。
解决办法:在业务允许的情况下,使用>=或<=这样的范围查询就不会失效
3、索引列运算
不要再索引列上进行运算,否则索引会失效
4、字符串不加引号
字符串类型字段使用时不加引号,索引将会失效
5、模糊查询
select * from emp where name like '@工程'
如果仅仅是尾部模糊匹配,索引不会失效。但若是头部模糊匹配,索引将会失效。
6、or连接的条件
用or分割开的条件,如果or前的条件中的列有索引,而后面的列中没有索引,那么所涉及到的索引都不会被用到。(只有两侧都有索引时,才会用到索引)
7、数据分布影响
如果MySQL评估使用索引比全表更慢,则不使用索引
8、SQL提示
是优化数据库的一个重要手段,简单来说,就是在SQL语句中加入一些人为的提示来达到优化操作的目的。
use index:建议使用
ignore index:不要使用
force index:必须使用
语法:
select * from 表名 use/ignore/force index(索引名) where 条件;
9、覆盖索引
尽量使用覆盖索引(查询使用了索引,并且需要返回的列,在该索引中已经全部能够找到),减少select *的使用。
extra中的内容(见本文索引的分类,理解MySQL是如何查询的)
有些版本可能没有
using index condition:查找使用了索引,但是需要回表查询
using where;using index:查询使用了索引,但是需要的数据都在索引列中能找到,所以不需要回表查询
一张表有四个字段(id username password status),由于数据量大,需要对以下SQL语句进行优化,该如何进行才是最佳方案:
select id,username,password from tb_user where username=’itcast’;
优化:建立联合查询
create index idx_un_pwd on tb_user(username,password);
10、前缀索引
当字段类型为字符串(varchar,text等)时,有时候需要索引很长的字符串,这会让索引变得很大,查询时,浪费大量的磁盘IO,影响查询效率。此时可以只将字符串的一部分前缀建立索引,这样可以大大提高索引空间,从而提高索引效率。
语法:create index idx_xxx on table_name(column(n));#提取字段前n个字符建立索引
前缀长度:可以根据索引的选择性来决定,而选择性是指不重复的索引值(基数)和数据表的记录总数的比值,索引选择性越高则查询效率越高,唯一索引的选择性是1,这是最好的索引选择性,性能也是最好的。
选择性公式:
select count(distinct email)/count() from tb_user;
select count(distinct substr(email,1,5))/count() from tb_user; 截取1-5 的字符
11、单列索引和联合索引的选择
在业务场景中,如果存在多个查询条件,考虑针对于查询字段建立索引是,建议建立联合索引,而非单列索引(因为查询时,只会使用一个字段的索引,剩下的查询字段需要回表查询)
索引设计原则
- 针对于数据量较大,且查询比较频繁的表建立索引。
- 针对于常作为查询条件(where)、排序(order by)、分组(group by)操作的字段建立索引。
- 尽量选择区分度高的列作为索引,尽量建立唯一索引,区分度越高,使用索引的效率越高。
- 如果是字符串类型的字段,字段的长度较长,可以针对于字段的特点,建立前缀索引。
- 尽量使用联合索引,减少单列索引,查询时,联合索引很多时候可以覆盖索引,节省存储空间,避免回表,提高查询效率。
- 要控制索引的数量,索引并不是多多益善,索引越多,维护索引结构的代价也就越大,会影响增删改的效率。
- 如果索引列不能存储NULL值,请在创建表时使用NOT NULL约束它。当优化器知道每列是否包含NULL值时,它可以更好地确定哪个索引最有效地用于查询。
三、SQL语句的优化
插入数据(insert优化)
如果我们需要一次性往数据库表中插入多条记录,可以从以下三个方面进行优化。
优化方案一:批量插入数据
Insert into tb_test values(1,’Tom’),(2,’Cat’),(3,’Jerry’);
即便是批量插入也不建议一次性插入太多,500-1000条较为合适。如果需要插入更多,建议分割成多次进行插入
为什么批量插入不建议太多
对于批量插入数据,确实不建议一次性插入太多记录,通常建议控制在500到1000条左右的范围内。这是因为一次性插入大量数据可能会导致以下问题:
-
事务大小:插入太多记录可能导致事务变得非常大,这会增加数据库的资源消耗和锁定时间,从而影响其他事务的性能。
-
内存消耗:大批量插入可能需要大量的内存来处理,这可能导致数据库服务器的内存不足,从而导致性能下降或崩溃。
-
日志写入:每次插入操作都会写入事务日志,大批量插入会导致大量的日志写入,增加了磁盘IO负担。
-
锁定和竞争:大批量插入可能会导致与其他操作的锁定竞争,影响并发性能。
为了避免这些问题,通常建议将批量插入分批进行,每次插入500到1000条记录,然后在每个批次之间进行提交。这样可以控制事务的大小,减少内存消耗,降低日志写入量,并减少锁定竞争,从而提高性能和稳定性。
此外,如果可能的话,可以考虑使用数据库特定的批量插入工具或语法,以进一步优化性能。例如,在MySQL中,可以使用INSERT INTO ... VALUES (), (), ...语法来一次性插入多行数据,而不是多个单独的INSERT语句。不同数据库管理系统可能具有不同的优化策略,因此要根据具体的数据库系统来选择合适的方法。
优化方案二:手动提交数据
在MySQL当中,默认是自动提交的,也就是意味着你每执行完一条insert语句便会自动提交。这样会涉及到频繁的事务的开启和提交,所以我们可以手动控制事务
insert into tb_test values(1,’tom’);
insert into tb_test values(2,’cat’);
insert into tb_test values(3,’jerry’);
优化方案三:主键顺序插入
主键顺序插入,性能要高于乱序插入。
这种方法可以帮助确保主键值按照顺序分配,从而提高性能并减少竞争
主键乱序插入 : 8 1 9 21 88 2 4 15 89 5 7 3
主键顺序插入 : 1 2 3 4 5 7 8 9 15 21 88 89
大批量数据插入
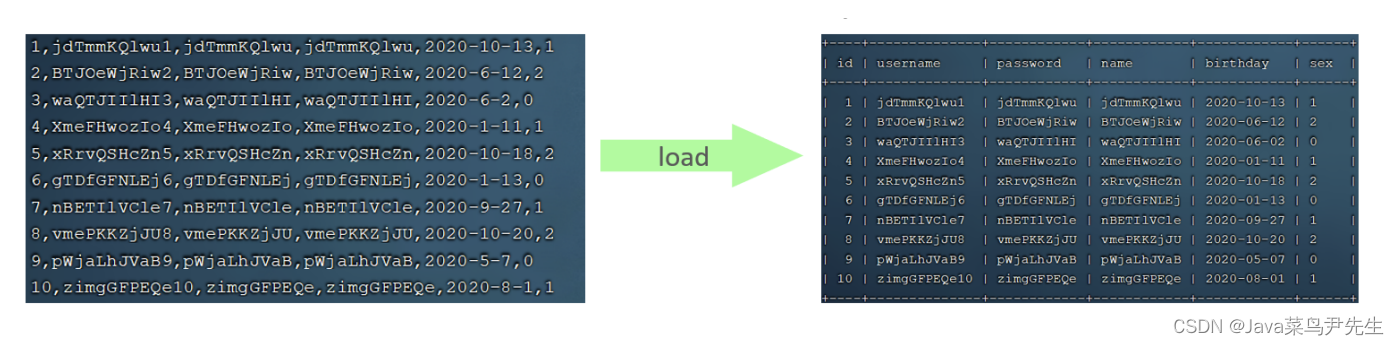
如果一次性需要插入大批量数据(比如: 几百万的记录),使用insert语句插入性能较低,此时可以使 用MySQL数据库提供的load指令进行插入。
通过load指令,我们可以一次性将本地文件当中的数据,全部加载到数据库当中
操作如下:
操作
表示当连接到服务器时,需要去加载本地文件
-- 客户端连接服务端时,加上参数 -–local-infile
mysql –-local-infile -u root -p

-- 设置全局参数local_infile为1,开启从本地加载文件导入数据的开关
set global local_infile = 1;

-- 执行load指令将准备好的数据,加载到表结构中
load data local infile '/root/sql1.log' into table tb_user
fields terminated by ',' lines terminated by '\n' ;
在load时,主键顺序插入性能高于乱序插入
主键优化
1、数据组织方式:在InnoDB存储引擎中,表数据都是根据主键顺序组织存放的,这种存储方式的表称为索引组织表(index organized table IOT)。
2、页分裂:页可以为空,也可以填充一半,也可以填充满,每个页包含了2-N行数据(如果一行数据过大,会行溢出),根据主键排列。
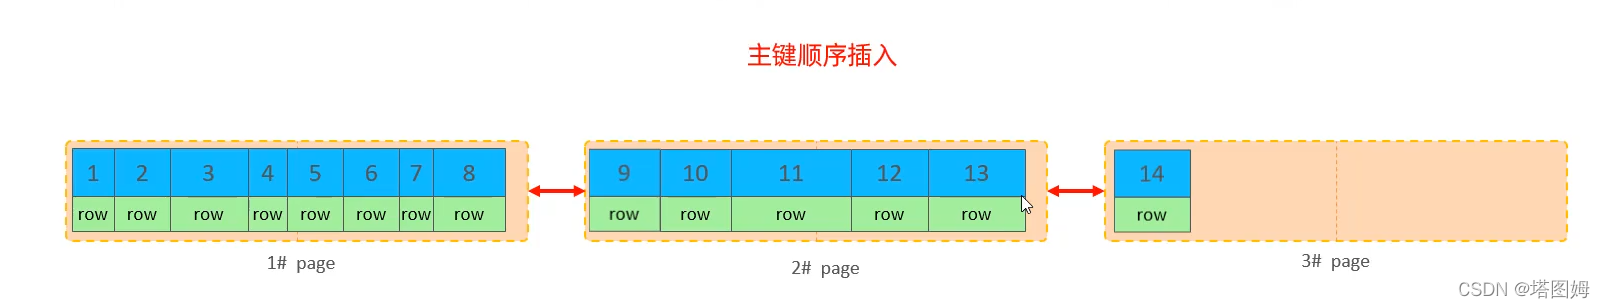
主键顺序插入:依次插入页满了则开辟新的页继续插入。
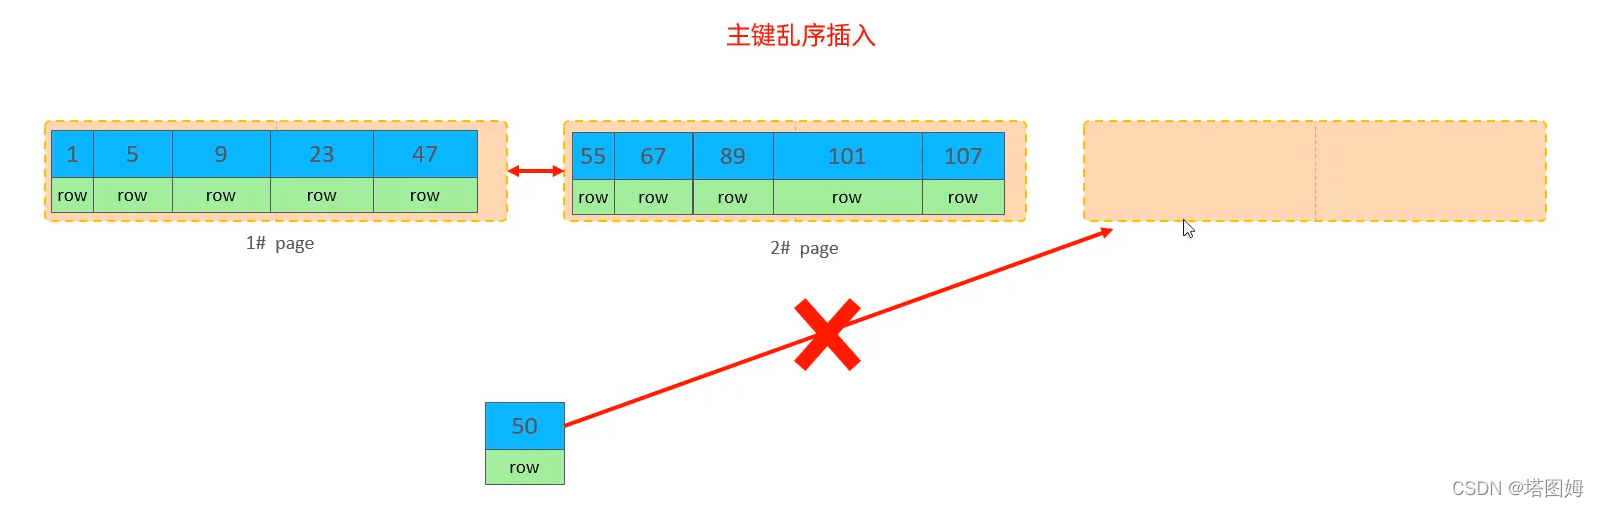
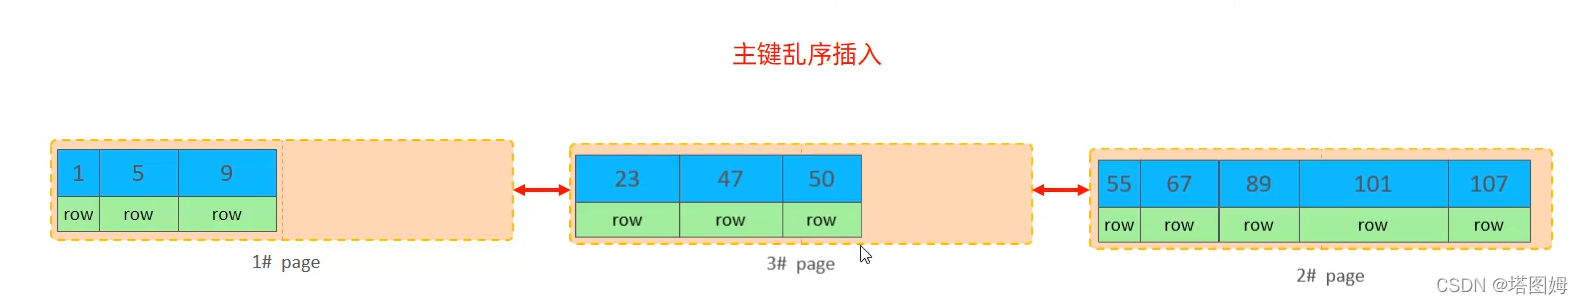
主键乱序插入:如图,第50行的数据要插入到第47行之后,而第一页已经满了,需要开辟一个新的页,将第一页中后二分之一的数据移动到新开辟的页,再将第50行的数据插入,最后修改链表指针,这就是页分裂现象。结果如下:
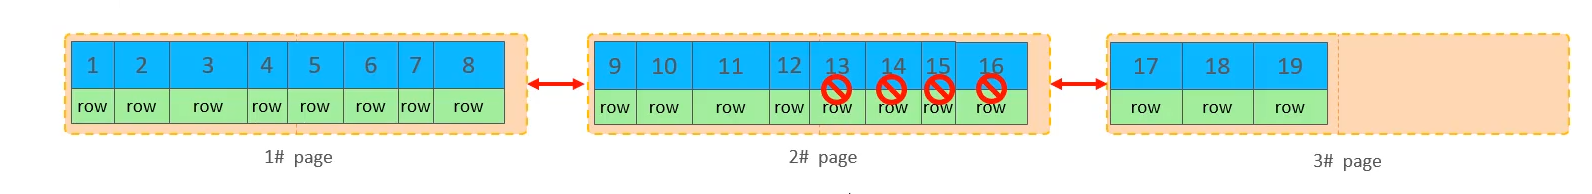
3、页合并:当删除一行记录时,实际上记录并没有被物理删除,只是被标记为删除并且它的空间变得允许被其他记录声明使用。当页中删除的记录达到MERGE_THRESHOLD(默认为页的50%),InnoDB会开始寻找最靠近的页(前或后)看看是否可以将两个页合并以优化空间使用
4、主键的设计原则
①满足业务需求的情况下,尽量降低主键的长度。
②插入数据时,尽量使用顺序插入,选择使用AUTO_INCREMENT自增主键。
③尽量不要使用UUID做主键或者其他自然主键,如身份证号。
④业务操作时,避免对主键的修改。
order by优化
1、 Using filesort:通过表的索引或全表扫描,读取满足条件的数据行,然后在排序缓冲区sort buffer中完成排序操作,所有不是通过索引直接返回排序结果的排序都叫Filesort排序。
2、 Using index:通过有序索引顺序扫描直接返回有序数据,这种情况即为using index,不需要额外排序,操作效率高。
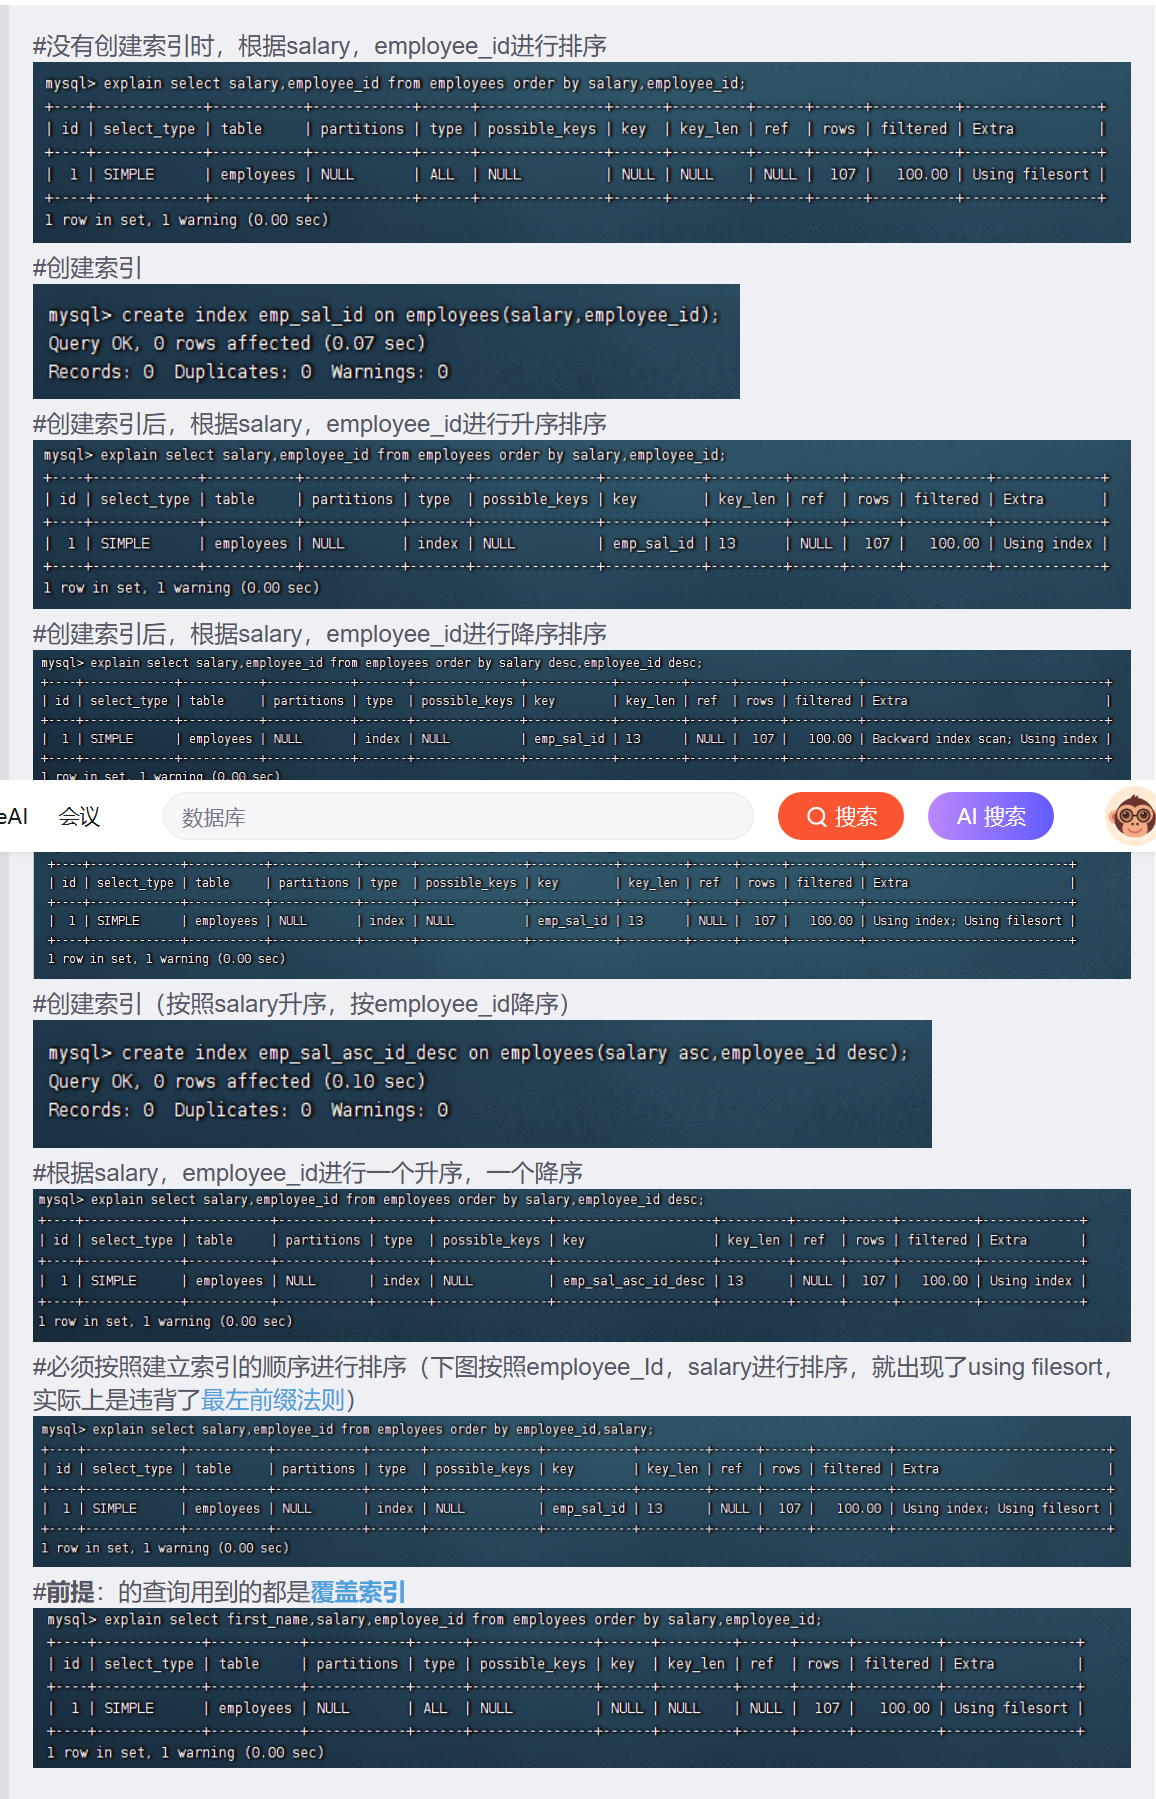
总结:
1、根据排序字段建立合适的索引,多字段排序时,也遵循最左前缀法则
2、尽量使用覆盖索引
3、多字段排序,一个升序一个降序,此时需注意联合索引在创建时的规则(asc/desc)
4、如果不可避免的出现filesort,大数据量排序时,可以适当增大排序缓冲区大学sort_buffer_size(默认256k)
group by优化
limit优化
一个常见又非常头疼的问题就是limit 200000,10,此时需要MySQL排序前200010条记录,仅仅返回200000-200010的记录,其他记录丢弃,查询排序的代价非常大。
优化思路:一般分页查询时,通过创建覆盖索引能够比较好地提高性能,可以通过覆盖索引加子查询形式进行优化。
select s.* from emp , (select id from emp order limit 10000,10) a where s.id=a.id
count优化
explain select count(*) from tb_user;
1、MyISAM引擎把一个表的总行数存在了磁盘上,因此执行count()的时候会直接返回这个数,效率很高。(前提是没有查询条件)
2、InnoDB引擎,它执行count()时,需要把数据一行一行地从引擎里面读出来,然后累计计数。
优化思路:自己计数。 插入时计数加一,删除减一,自己维护一个计数。
count的几种用法:
count()是一个聚合函数,对于返回的结果集,一行行的判断,如果count函数的参数不是NULL,累计值就加1,最后返回累计值。
用法:count(*),count(主键),count(字段),count(1);
1、count(主键):InnoDB引擎会遍历整张表,把每一行的主键id值都取出来,返回给服务层。服务层拿到主键后,直接按行进行累加(主键不可能时null)。
2、count(字段):
没有not null 约束 : InnoDB 引擎会遍历整张表把每一行的字段值都取出来,返回给服务层,服务层判断是否为null,不为null,计数累加。
有not null 约束:InnoDB 引擎会遍历整张表把每一行的字段值都取出来,返回给服务层,直接按行进行累加。
3、count(1):InnoDB 引擎遍历整张表,但不取值。服务层对于返回的每一行,放一个数字“1”进去,直接按行进行累加。
4、count(*):InnoDB引擎并不会把全部字段取出来而是专门做了优化不取值服务层直接按行进行累加
update优化(避免行锁升级为表锁)
update employees last_name ='john' where employee_id = 1;
//此时employees表中这行有锁,其他事务不能操作这行,但可以操作别的行


update employees last_name ='john' where last_name='juice';
//此时行锁会升级为表锁,即其他事务不能操作这个表

//给last_name创建索引
create index emp_ln on employees(last_name);

update employees last_name ='john' where last_name='juice';
//此时就不会升级为表锁
四、视图
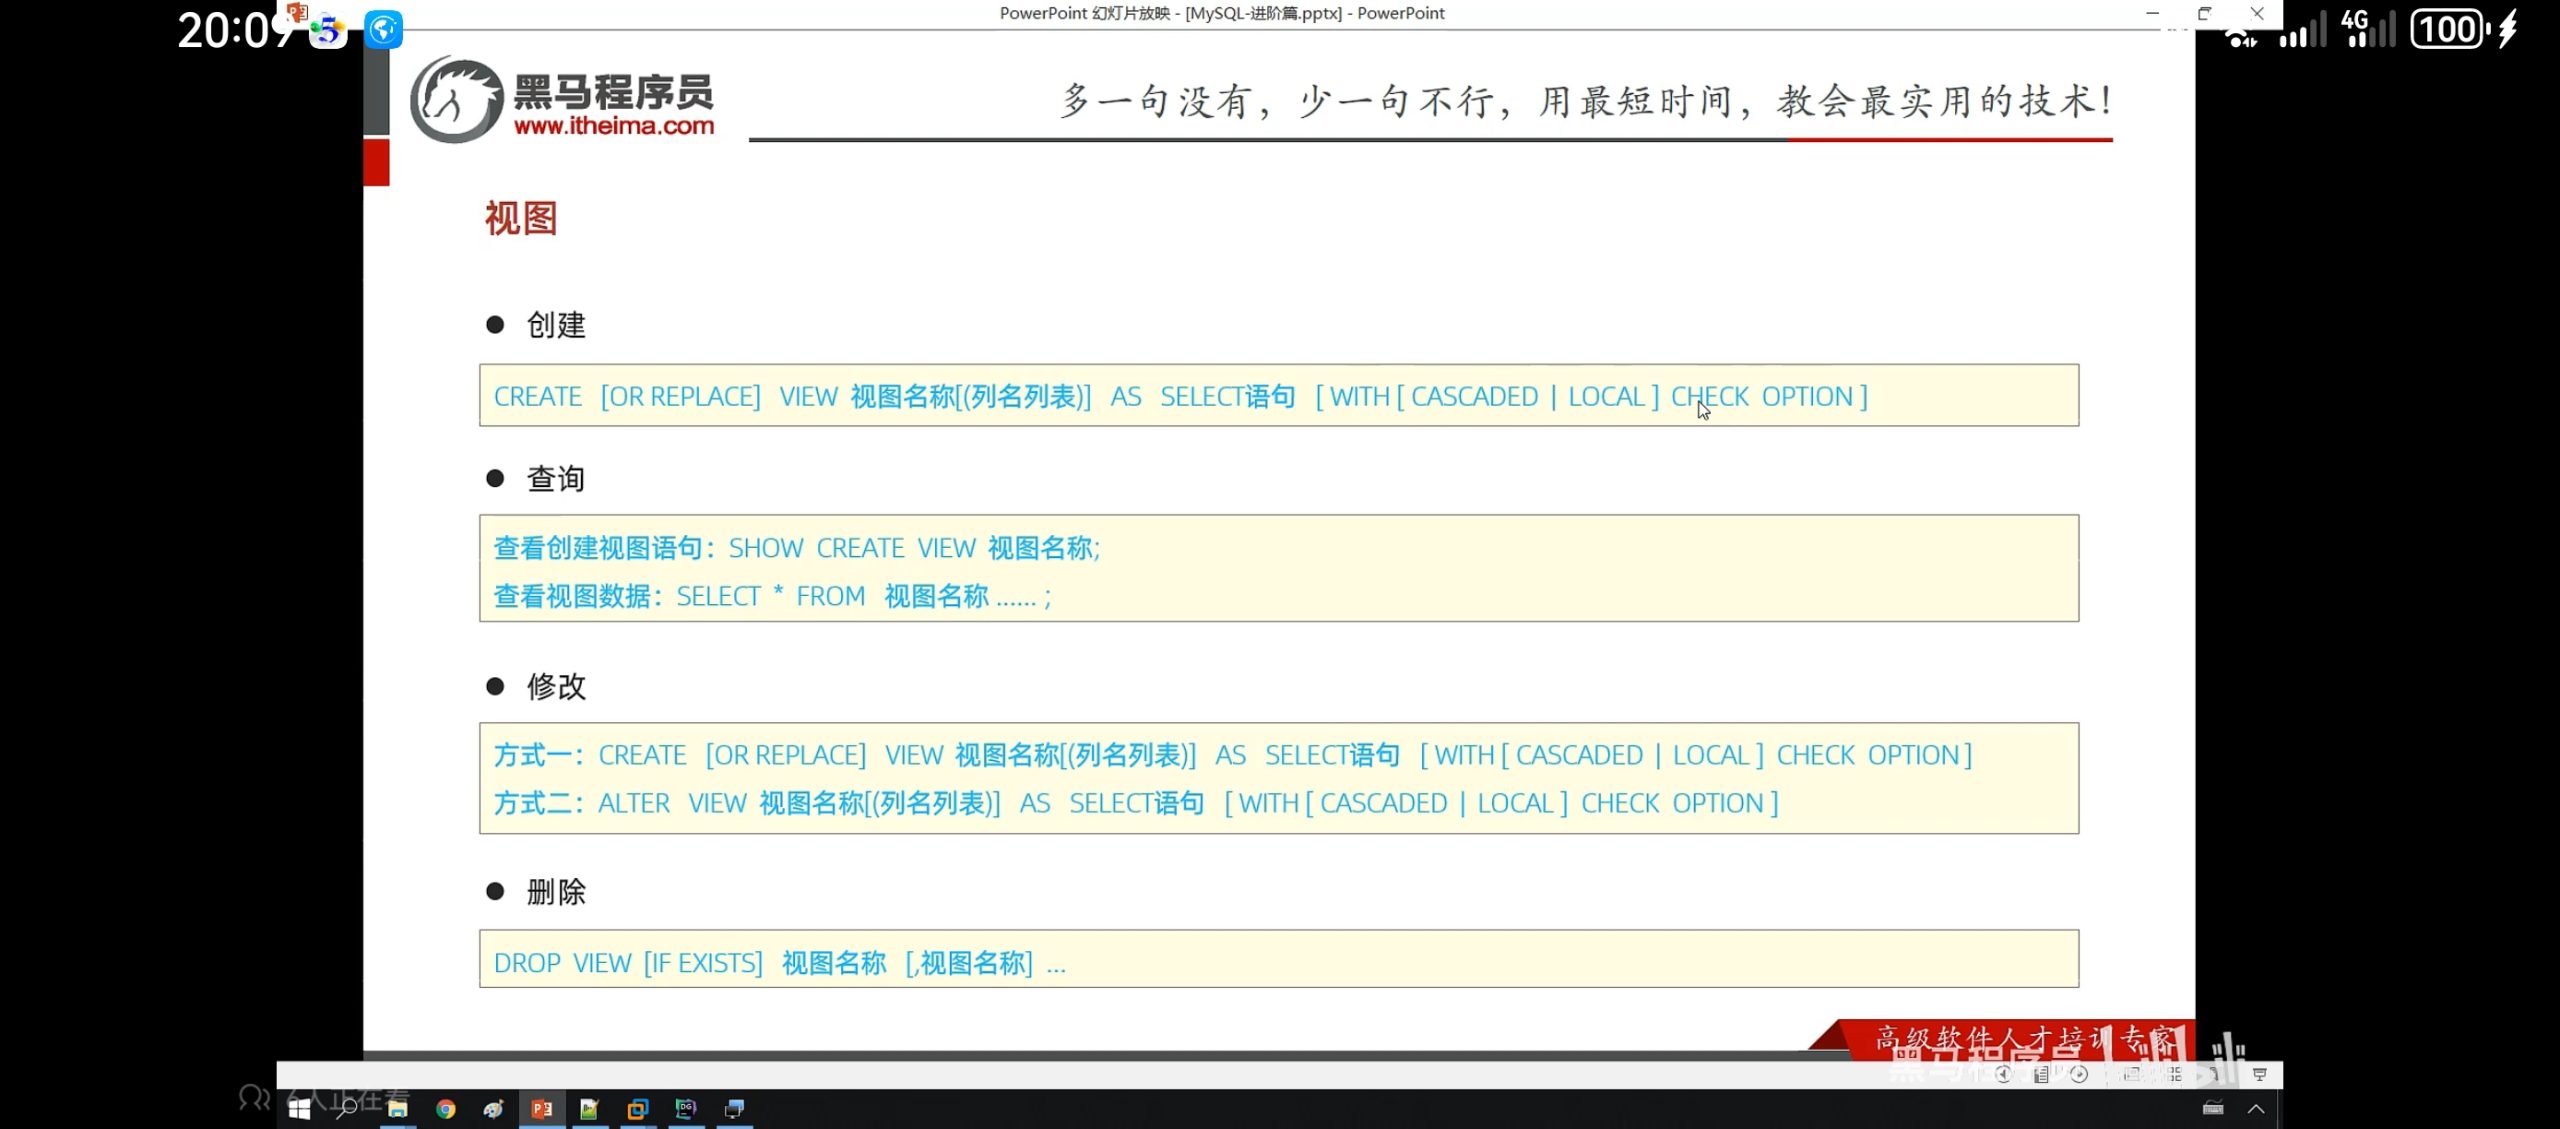
检查选项
cascaded
#case1
#创建一个基于students表的视图
create or replace view v1 as select id,name from students where id<=20;
#由于没有检查选项,所以插入id>20的数据也会插入成功
insert into v1 values(21,'john');#插入成功

#case2
#创建一个基于v1的视图,并添加cascaded检查选项
create or replace view v2 as select id,name from v1 where id>10 with cascaded check option;

#添加检查选项后,再插入数据,MySQL就会判断插入数据是否满足条件,
#由于此视图是基于v1的,所以现在可以插入的id值为 10<id<=20。
insert into v2 values(22,'lucy');#插入失败

#case3
#创建一个基于v2的视图
create or replace v3 as select id,name from v2 where id<=15;

#由于v3没有添加检查选项,但v3是基于v2的,所以现在可以插入的id值依然为 10<id<=20。
insert into v3 values(18,'Tom');#插入成功

insert into v3 values(24,'kobe');#插入失败
当我们操作当前视图时,cascaded检查选项是,如果当前视图有检查选项,则插入数据要满足包括当前视图条件以及满足当前视图所依赖的视图的条件。如果当前视图没有检查选项,则插入数据要满足当时视图所依赖视图有检查选项及其依赖的视图的条件。
local
当我们在操作当前视图时,local检查选项是递归的查找当前视图所依赖的视图是否有检查选项,如果有,则检查;如果没有,就不做检查。
#case1
#创建一个基于students表的视图
create or replace view v1 as select id,name from students where id<=20;

insert into v1 values(21,'john');#插入成功

#case2
#创建一个基于v1的视图,并添加local检查选项
create or replace view v2 as select id,name from v1 where id>10 with local check option;

#添加检查选项后,再插入数据,MySQL就会判断插入数据是否满足条件,
#由于此视图是基于v1的,v1没有检查选项,所以现在可以插入的id值为 id>10。
insert into v2 values(22,'lucy');#插入成功

#case3
#创建一个基于v2的视图
create or replace v3 as select id,name from v2 where id<=15;

#由于v3没有添加检查选项,但v3是基于v2的,所以现在可以插入的id值依然为 id>10。
insert into v3 values(18,'Tom');#插入成功
五、存储过程
对底层SQL语句的封装和重用
-- 存储基本语法
create procedure p1()
begin
    select count(*) from student;
end;
-- 调用
call p1();

-- 查看
select * from information_schema.ROUTINES where ROUTINE_SCHEMA ='text';
show create procedure p1;

-- 删除
drop procedure if exists p1;
在命令行中操作时需要用delimiter $$ 将分号定义为 $$
变量
系统变量
 在MySQL中变量分为三种类型: 系统变量、用户定义变量、局部变量。

    1) 系统变量

    系统变量 是MySQL服务器提供,不是用户定义的,属于服务器层面。分为全局变量(GLOBAL)、会话变量(SESSION)。

    1). 查看系统变量
SHOW [ SESSION | GLOBAL ] VARIABLES ; -- 查看所有系统变量
SHOW [ SESSION | GLOBAL ] VARIABLES LIKE '......'; -- 可以通过LIKE模糊匹配方式查找变量
SELECT @@[SESSION | GLOBAL] 系统变量名; -- 查看指定变量的值
2). 设置系统变量
SET [ SESSION | GLOBAL ].系统变量名 = 值 ;
SET @@[SESSION | GLOBAL].系统变量名 = 值 ;
注意:
    如果没有指定SESSION/GLOBAL,默认是SESSION,会话变量。

            A. 全局变量(GLOBAL): 全局变量针对于所有的会话。

            B. 会话变量(SESSION): 会话变量针对于单个会话,在另外一个会话窗口就不生效了。
自定义变量
不用提前声明
-- 用户变量
set @myname='itcast';
set @age=10;
set @mygender='男',@myhobby='c';
select  @mycolor :='red';
select count(*) into @mycount from emp;


-- 使用
select @myname,@mygender,@age,@myhobby;
select @mycount;
局部变量
范围在begin和end 之间
-- 局部变量
create procedure p2()
begin
    declare stu_count int default 0;
    set stu_count=200;
    select stu_count;
end;
流程控制
if语句
IF 条件1 THEN
.....
ELSEIF 条件2 THEN -- 可选
.....
ELSE -- 可选
.....
END IF;
在if条件判断的结构中,ELSE IF 结构可以有多个,也可以没有。 ELSE结构可以有,也可以没有。
create procedure p3()
begin
    declare score int default 58;
    declare result varchar(10);
    if score>=85 then
        set result:='优秀';
    elseif score >=60 then
        set result:='合格';
    else
        set result:='不及格';
    end if;
    select result;
end;

call p3();
in/out/inout 参数 输入,输出,输入和输出
create procedure p4(in score int,out result varchar(10))
begin

    if score>=85 then
        set result:='优秀';
    elseif score >=60 then
        set result:='合格';
    else
        set result:='不及格';
    end if;
end;

call p4(66,@result);
select @result;

create procedure p5(inout score double)
begin
    set score := score *0.5;
end;

set @score=78;
call p5(@score);
select @score;
case
语法1
-- 含义: 当case_value的值为 when_value1时,执行statement_list1,当值为 when_value2时,
执行statement_list2, 否则就执行 statement_list
CASE case_value
    WHEN when_value1 THEN statement_list1
    [ WHEN when_value2 THEN statement_list2] ...
    [ ELSE statement_list ]
END CASE;
语法2
-- 含义: 当条件search_condition1成立时,执行statement_list1,当条件search_condition2成
立时,执行statement_list2, 否则就执行 statement_list
CASE
    WHEN search_condition1 THEN statement_list1
    [WHEN search_condition2 THEN statement_list2] ...
    [ELSE statement_list]
END CASE;
while
while 循环是有条件的循环控制语句。满足条件后,再执行循环体中的SQL语句。具体语法为:
-- 先判定条件,如果条件为true,则执行逻辑,否则,不执行逻辑
WHILE 条件 DO
    SQL逻辑...
END WHILE;
repeat
repeat是有条件的循环控制语句, 当满足until声明的条件的时候,则退出循环 。具体语法为:
-- 先执行一次逻辑,然后判定UNTIL条件是否满足,如果满足,则退出。如果不满足,则继续下一次循环
REPEAT
    SQL逻辑...
UNTIL 条件
END REPEAT;
loop
LOOP可以配合一下两个语句使用:
LEAVE :配合循环使用,退出循环。
ITERATE:必须用在循环中,作用是跳过当前循环剩下的语句,直接进入下一次循环
[begin_label:] LOOP
    SQL逻辑...
END LOOP [end_label];

LEAVE label; -- 退出指定标记的循环体
ITERATE label; -- 直接进入下一次循环
游标
存储查询结果集的数据类型,游标的使用包括游标的声明,open,fetch和close
1). 介绍
游标(CURSOR)是用来存储查询结果集的数据类型 , 在存储过程和函数中可以使用游标对结果集进行循环的处理。游标的使用包括游标的声明、OPEN、FETCH 和 CLOSE,其语法分别如下。
   A. 声明游标
DECLARE 游标名称 CURSOR FOR 查询语句 ;

       B. 打开游标

OPEN 游标名称 ;

        C. 获取游标记录

FETCH 游标名称 INTO 变量 [, 变量 ] ;

        D. 关闭游标

CLOSE 游标名称 ;
条件处理程序
DECLARE handler_action HANDLER FOR condition_value [, condition_value]  ... statement ;
handler_action 的取值:
    CONTINUE: 继续执行当前程序
    EXIT: 终止执行当前程序
condition_value 的取值:
    SQLSTATE sqlstate_value: 状态码,如 02000
    SQLWARNING: 所有以01开头的SQLSTATE代码的简写
    NOT FOUND: 所有以02开头的SQLSTATE代码的简写
    SQLEXCEPTION: 所有没有被SQLWARNING 或 NOT FOUND捕获的SQLSTATE代码的简写
案例
create procedure p11(in uage int)
begin
    declare uname varchar(100);
    declare ujob varchar(100);
    declare u_cursor cursor for select name ,job from emp where age<=uage;
    declare exit handler for SQLSTATE '02000' close u_cursor;
    create table if not exists tb_user_job(
        id int primary key auto_increment,
        name varchar(100),
        job varchar(100)
    );
    open u_cursor;
    while true do
        fetch u_cursor into uname,ujob;
        insert into tb_user_job values (null,uname,ujob);
        end while;
    close u_cursor;
end;
六、存储函数
语法结构
CREATE FUNCTION 存储函数名称 ([ 参数列表 ])
RETURNS type [characteristic ...]
BEGIN
    -- SQL语句
    RETURN ...;
END ;
  characteristic说明:

            DETERMINISTIC:相同的输入参数总是产生相同的结果

            NO SQL :不包含 SQL 语句。

            READS SQL DATA:包含读取数据的语句,但不包含写入数据的语句。
七、触发器
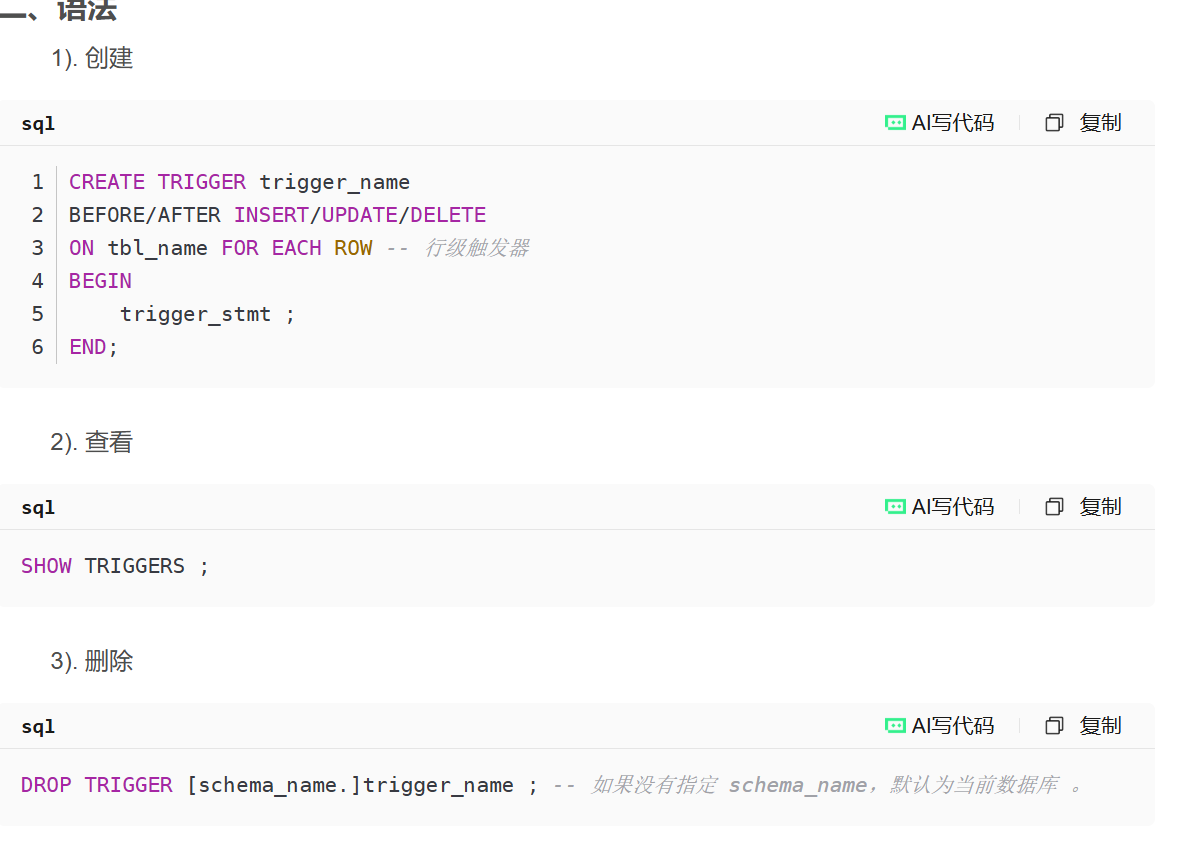
触发器是与表有关的数据库对象,指在insert/update/delete之前(BEFORE)或之后(AFTER),触发并执行触发器中定义的SQL语句集合。触发器的这种特性可以协助应用在数据库端确保数据的完整性, 日志记录 , 数据校验等操作 。
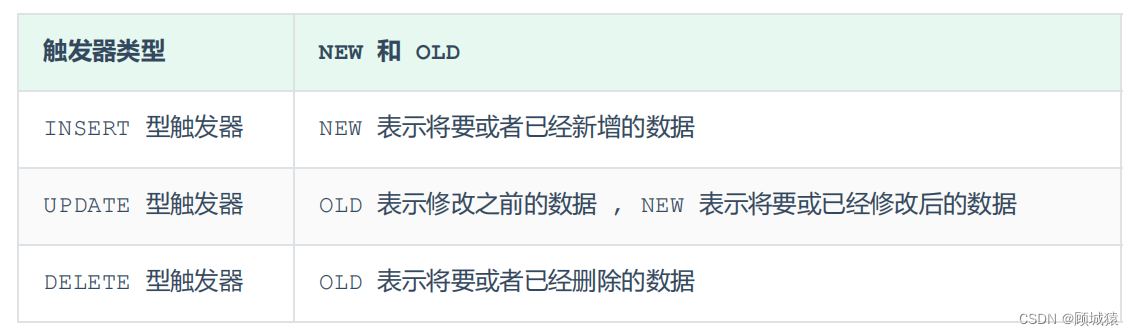
    使用别名OLD和NEW来引用触发器中发生变化的记录内容,这与其他的数据库是相似的。现在触发器还只支持行级触发,不支持语句级触发。

    行级触发是指当执行的语句影响到了几行,触发器就执行几次。而语句级触发只是和某个语句的执行有关,执行一次语句,就会触发一次
八、锁
锁是计算机协调多个进程或线程并发访问某一资源的机制。*在数据库中,除传统的计算资源(CPU、RAM、I/O)的争用以外,数据也是一种供多用户共享的资源。如何保持数据并发的一致性,有效性是所有数据库必须解决的一个问题,锁冲突也是影响数据库并发访问性能的一个重要因素。从这个角度来说,锁对数据库而言显得尤其重要,也更加复杂。
全局锁
#加锁
flush tables with read lock;

#做备份
mysqldump -uroot -p密码 数据库名>备份到的文件;
mysqldump -uroot -p1234 itcast>itcast.sql

#解锁
unlock tables;
数据库中加全局锁,是一个比较重的操作,存在以下问题:
1、如果在主库上备份,那么在备份期间都不能执行更新,业务基本上就得停摆
2、如果在从库上备份,那么在备份期间不能执行主库同步过来的二进制日志(binlog),会导致主从延迟。
表级锁
表级锁,每次操作锁住整张表。锁定粒度大,发生锁冲突的概率最高,并发度最低。应用在MyISAM、InnoDB、BDB等存储引擎中。
分类:
1、表锁
2、元数据锁(meta data lock,MDL)
3、意向锁
1、表锁
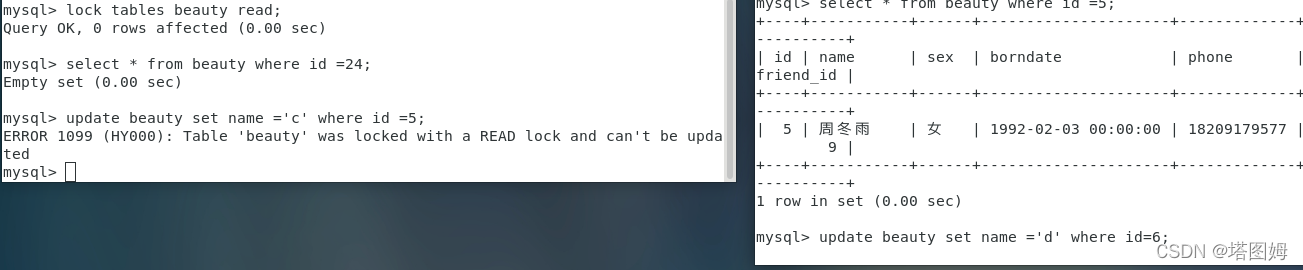
可以看到,当加了读锁之后客户端都可以读,但是都不可以改。
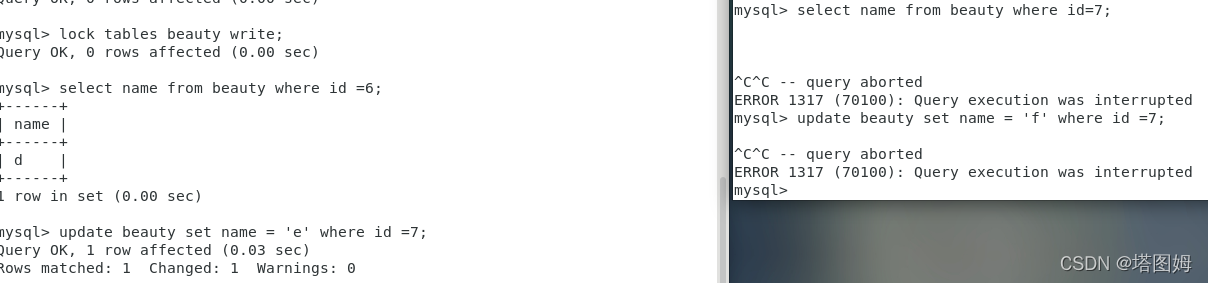
当加了写锁之后,加锁的那个客户端既可以读也可以写,但是其他客户端都不能进行读写
#加锁
lock tables 表名... read/write
#释放锁
unlock tables /客户端连接关闭
2.元数据锁
MDL加锁的过程是系统自动控制,无需显式使用,在访问一张表的时候会自动加上。MDL锁的主要作用是维护表元数据的数据一致性,在表上有活动事务的时候,不可以对元数据进行写入操作。
为了避免DML和DDL冲突,保证数据读写的正确性。
在MySQL5.5中引入MDL,当对一张表进行增删改查的时候,加MDL读锁(共享);当对表结构进行变更操作的时候,加MDL写锁(排他)。
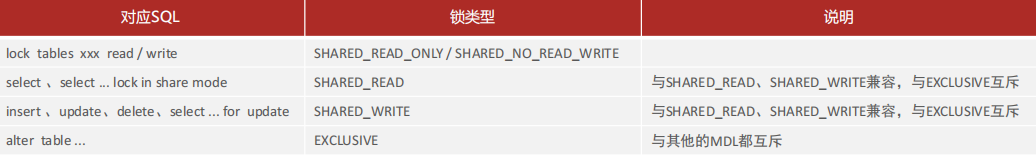
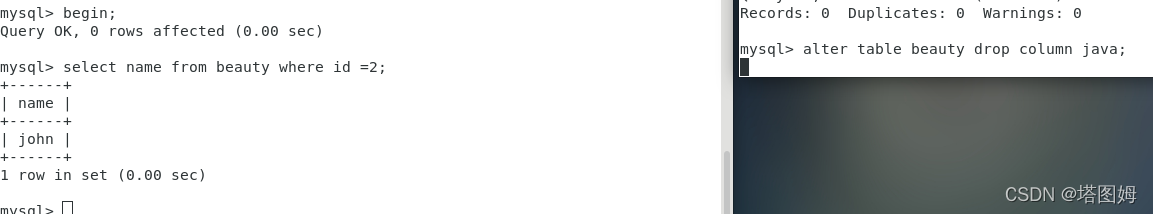
查看元数据锁:select object_type,object_schema,object_name,lock_type,lock_duration from performance_schema.metadata_locks;
意向锁
为了避免DML在执行时,加的行锁与表锁的冲突,在InnoDB中引入了意向锁,使得表锁不用检查每行数据是否加锁,使用意向锁来减少表锁的检查。(提高性能)
描述
引入意向锁之前:假设线程A对开启一个事务,并对某行进行更新,此时系统会为这行添加表锁。同时线程B要对这个表添加表锁,系统要依次检查表中是否有行锁。效率很低。
引入意向锁之后:假设线程A对开启一个事务,并对某行进行更新,此时系统会为这行添加表锁,与此同时也会为这个表加一个意向锁。同时线程B要对这个表添加表锁,系统只需检查这个意向锁与表锁是否兼容即可。大大提高了效率
1)意向共享锁(IS):由语句select…lock in share mode添加 。与表锁的共享锁兼容,排他锁互斥。。
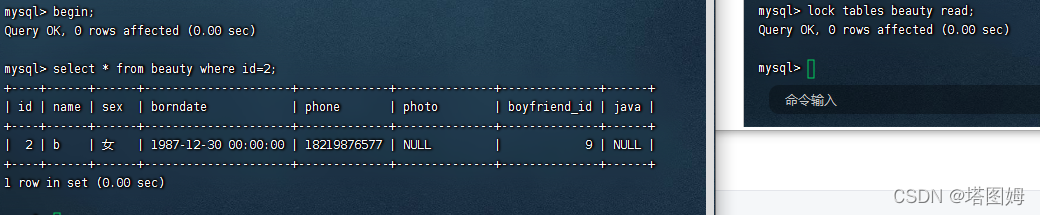
2)意向排他锁(IX):由insert、update、delete、select…for update添加。与表锁共享锁和排他锁都互斥。
意向锁之间不会互斥
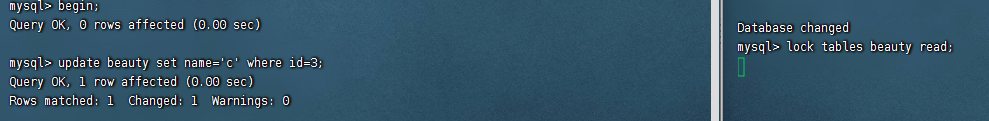
select object_schema,object_name,index_name,lock_type,lock_mode,lock_data from performance_schema.data_locks;
行级锁
行级锁,每次操作锁住对应的行数据。锁定粒度最小,发生锁冲突的概率最低,并发度最高。应用在InnoDB存储引擎中。
InnoDB的数据是基于索引组织的,行锁是通过对索引上的索引项加锁来实现的,而不是对记录加的锁。
对于行级锁,主要分为以下三类:
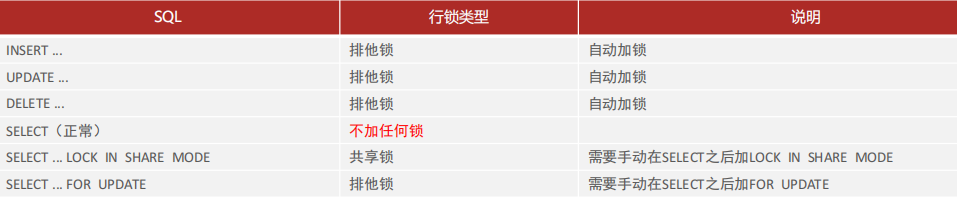
1. 行锁(Record Lock):锁定单个行记录的锁,防止其他事务对此行进行update和delete。在RC、RR隔离级别下都支持。
2. 间隙锁(Gap Lock):锁定索引记录间隙(不含该记录),确保索引记录间隙不变,防止其他事务在这个间隙进行insert,产生幻读。在RR隔离级别下都支持。
3. 临键锁(Next-Key Lock):行锁和间隙锁组合,同时锁住数据,并锁住数据前面的间隙Gap。在RR隔离级别下支持。
1、行锁
InnoDB实现了以下两种类型的行锁:
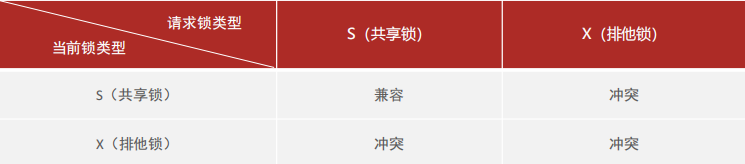
- 共享锁(S):允许一个事务去读一行,阻止其他事务获得相同数据集的排它锁。
- 排他锁(X):允许获取排他锁的事务更新数据,阻止其他事务获得相同数据集的共享锁和排他锁。
演示
默认情况下,InnoDB在 REPEATABLE READ事务隔离级别运行,InnoDB使用 next-key 锁进行搜索和索引扫描,以防止幻读。
- 针对唯一索引进行检索时,对已存在的记录进行等值匹配时,将会自动优化为行锁。
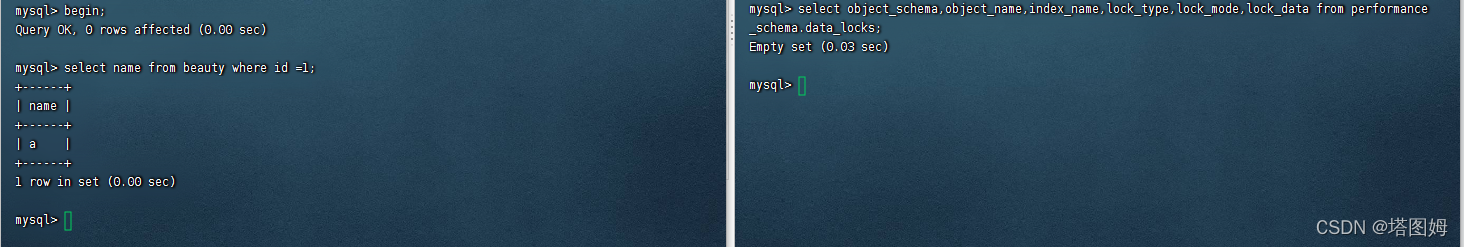
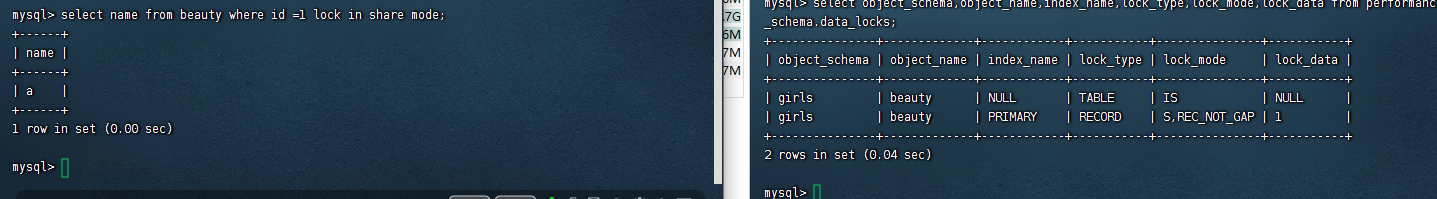
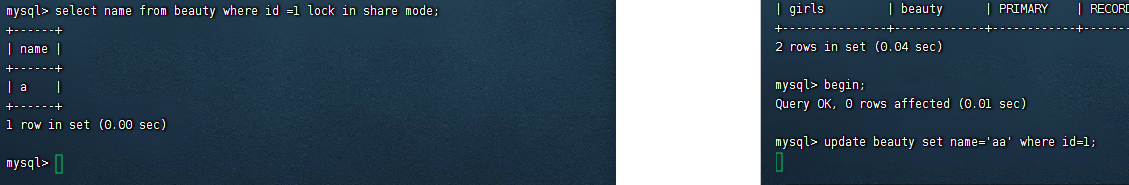
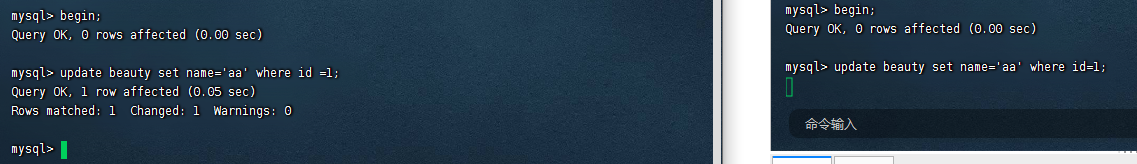
2.InnoDB的行锁是针对于索引加的锁,不通过索引条件检索数据,那么InnoDB将对表中的所有记录加锁,此时 就会升级为表锁。
select object_schema,object_name,index_name,lock_type,lock_mode,lock_data from performance_schema.data_locks;
2.间隙锁/临键锁
默认情况下,InnoDB在 REPEATABLE READ事务隔离级别运行,InnoDB使用 next-key 锁进行搜索和索引扫描,以防止幻读。
索引上的等值查询(唯一索引),给不存在的记录加锁时, 优化为间隙锁 。
索引上的等值查询(普通索引),向右遍历时最后一个值不满足查询需求时,next-key lock 退化为间隙锁。
索引上的范围查询(唯一索引)–会访问到不满足条件的第一个值为止。
相关条目
- Mysql
- InnoDB引擎